LightSeek 发布开源推理引擎 TokenSpeed,控制面与执行面分离
lightseekorg / tokenspeed
LightSeek Foundation 发布开源 LLM 推理引擎 TokenSpeed,面向智能体负载,目标是在生产场景提供 TensorRT-LLM 级性能与 vLLM 级易用性。
面向智能体负载的开源推理引擎,控制面与执行面分离,已适配 Qwen、Kimi 等模型并给出吞吐数据。
TokenSpeed 是一款为 agentic 工作负载 设计的极速 LLM 推理引擎,具备 TensorRT-LLM 级别的性能和 vLLM 级别的易用性。其目标是成为生产级 agentic 工作负载性能最强的推理引擎。
核心组件:
- Scheduler:C++ 控制平面与 Python 执行平面。请求生命周期、KV 缓存所有权和重叠时序被编码为有限状态机,并通过类型系统在编译期强制实现安全的 KV 资源复用。
- Kernels:可插拔的分层内核系统,具有可移植的公共 API 和集中式注册表,其中包含面向 agentic 工作负载、在 Blackwell 上最快的 MLA(多头潜在注意力)实现之一。
- Entrypoint:集成 SMG 的 AsyncLLM,用于低开销的 CPU 侧请求处理。
差异化
TokenSpeed 采用了与现有 LLM 推理引擎根本不同的架构方法。PyTorch 基金会在 欢迎 TokenSpeed 加入 PyTorch 生态系统全景图时,重点强调了这些架构差异化优势:
TokenSpeed 是一款开源 LLM 推理引擎,也是首个将控制平面与执行平面分离的引擎。控制平面以 C++ 实现为有限状态机,利用类型系统在编译期而非运行时强制执行安全的资源管理,包括请求生命周期和 KV 缓存状态。执行平面以 Python 实现,支持快速迭代并降低研究人员和工程师的认知负担。这种架构将核心调度系统中强大的正确性保证与高层执行层的开发速度结合在一起。
TokenSpeed 还将内核视为一等模块化子系统,通过可移植的公共 API、集中式注册表和选择模型,以及面向异构加速器的可扩展插件机制,将其与核心引擎分离。
更重要的是,TokenSpeed 是开源 LLM 推理引擎中的 Switzerland:它保持中立,因为它由非营利组织 LightSeek Foundation 而非商业公司支持,并获得了 NVIDIA 和 AMD 等厂商的大力硬件和工程支持。
新闻
- [2026/10] 🔥 每用户 685 tokens/s:在 NVIDIA GB300 上使用 TokenSpeed 服务 Qwen3.8-Flash-Next。[博客]
- [2026/10] 🔥 使用 TokenSpeed 在 AMD Instinct MI355X GPU 上推进 Kimi K3 推理。[AMD 博客]
- [2026/09] GB300 上的 Kimi K3 优化 — 第一部分。[博客]
- [2026/08] Qwen3.8 Flash Next 首日支持,以及 GLM 5.3 Flash 首日支持。
- [2026/08] Qwen3.8 首日支持:使用 TokenSpeed 进行 2.4T 规模推理。[博客]
- [2026/08] TokenSpeed 加入 PyTorch 生态系统。
- [2026/07] Kimi K3 首日支持:使用 TokenSpeed 在领先平台上启用前沿模型。[博客]
- [2026/07] TML Inkling 首日支持:在 NVIDIA 和 AMD 上使用 TokenSpeed 进行 FP4 推理。[博客]
- [2026/06] 深入探讨 TokenSpeed-Kernel 的设计与优化。[PyTorch 博客]
- [2026/05] 🚀 TokenSpeed 在 Qwen3.5-397B-A17B 上针对 agentic 工作负载达到 580 TPS。[PyTorch 博客]
- [2026/05] TokenSpeed 发布 — 一款面向 agentic 工作负载的极速 LLM 推理引擎。[博客]
博客与演讲
如需阅读 LightSeek Foundation 的技术博客、会议演讲和工程文章,请访问 LightSeek 博客。
赞助商与合作伙伴
LightSeek 的工作得益于 AI 生态系统中 赞助商与合作伙伴 的支持。
性能对比
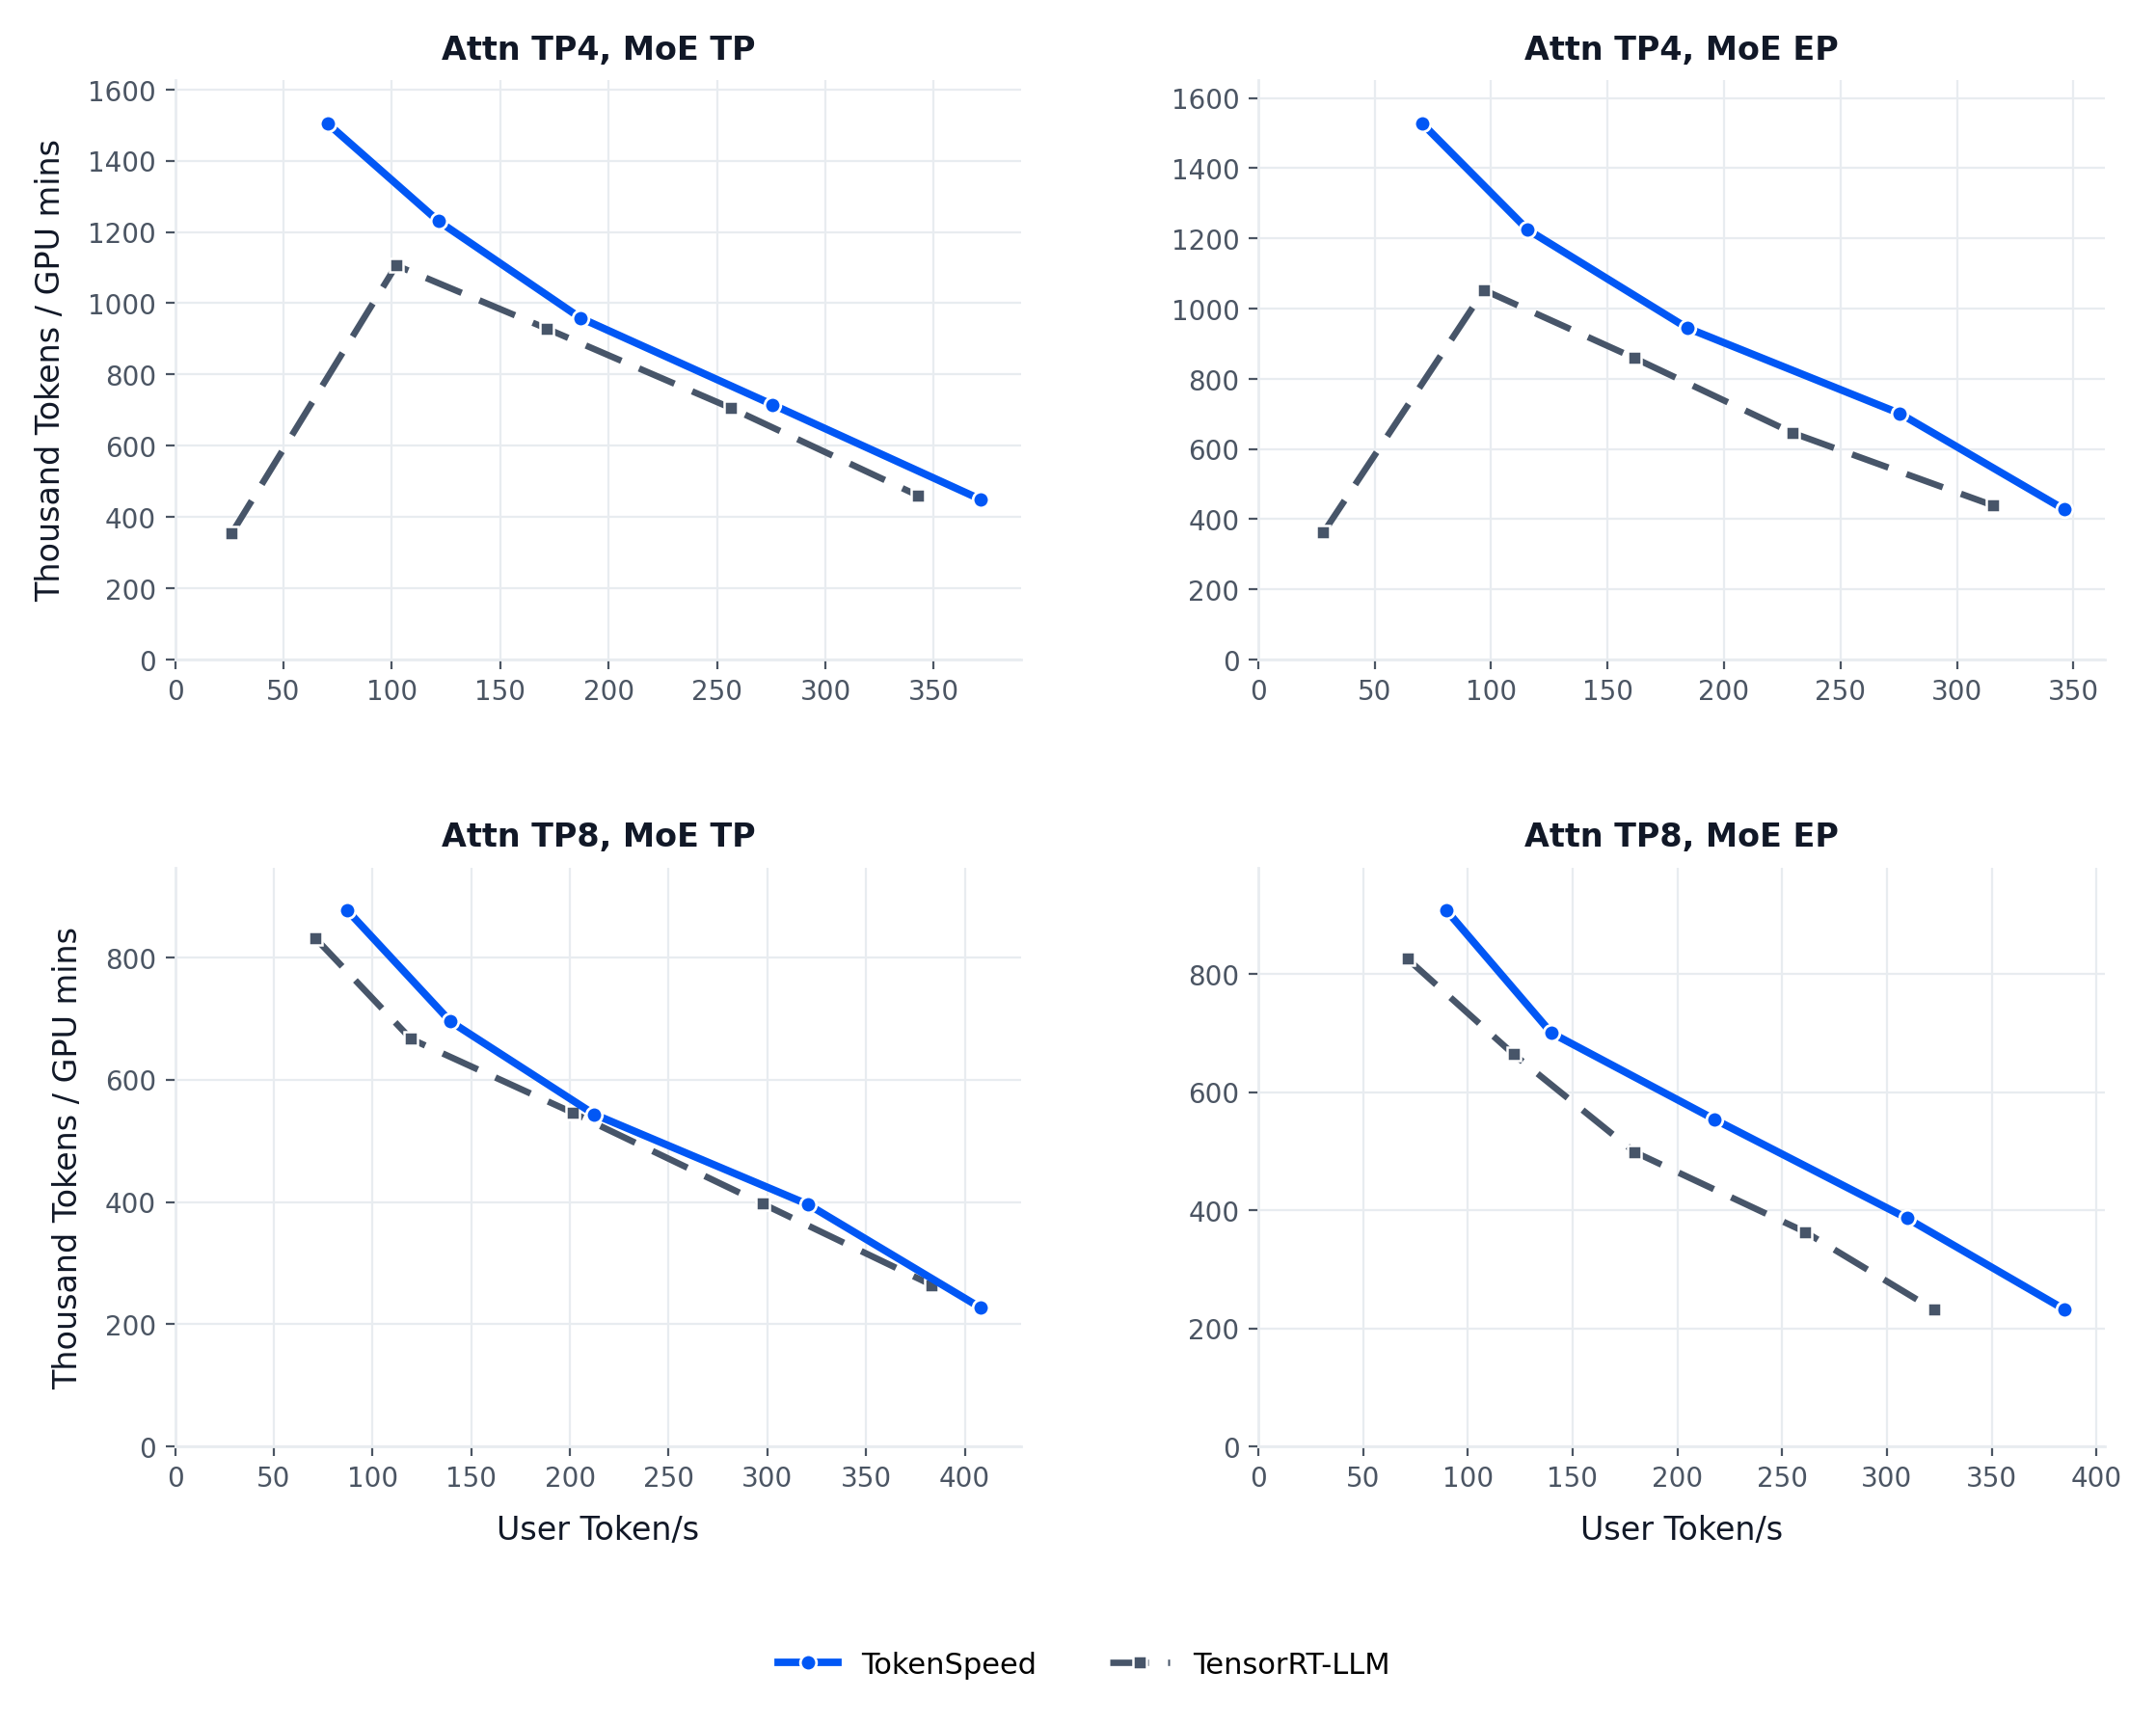
TokenSpeed 与 TensorRT-LLM 在智能体工作负载上的帕累托曲线(Kimi K2.5,B200)
文档
从这里开始:
引用
@misc{tokenspeed2026,
  author       = {{TokenSpeed Team}},
  title        = {{TokenSpeed}: A Speed-of-Light {LLM} Inference Engine},
  year         = {2026},
  howpublished = {\url{https://github.com/lightseekorg/tokenspeed}}
}
来源:web-github-trending · github.com